做 AI 短剧,为什么该让 Gemini 当眼睛和耳朵:31 个模型视听能力实测
AI 做短剧,自己却看不了片、听不了台词。同一段 mp4 发给 31 个模型:GPT、Claude、Grok 都没看到,Gemini 和 Qwen 能看能听。附选型、用法和它会骗你的四个地方。
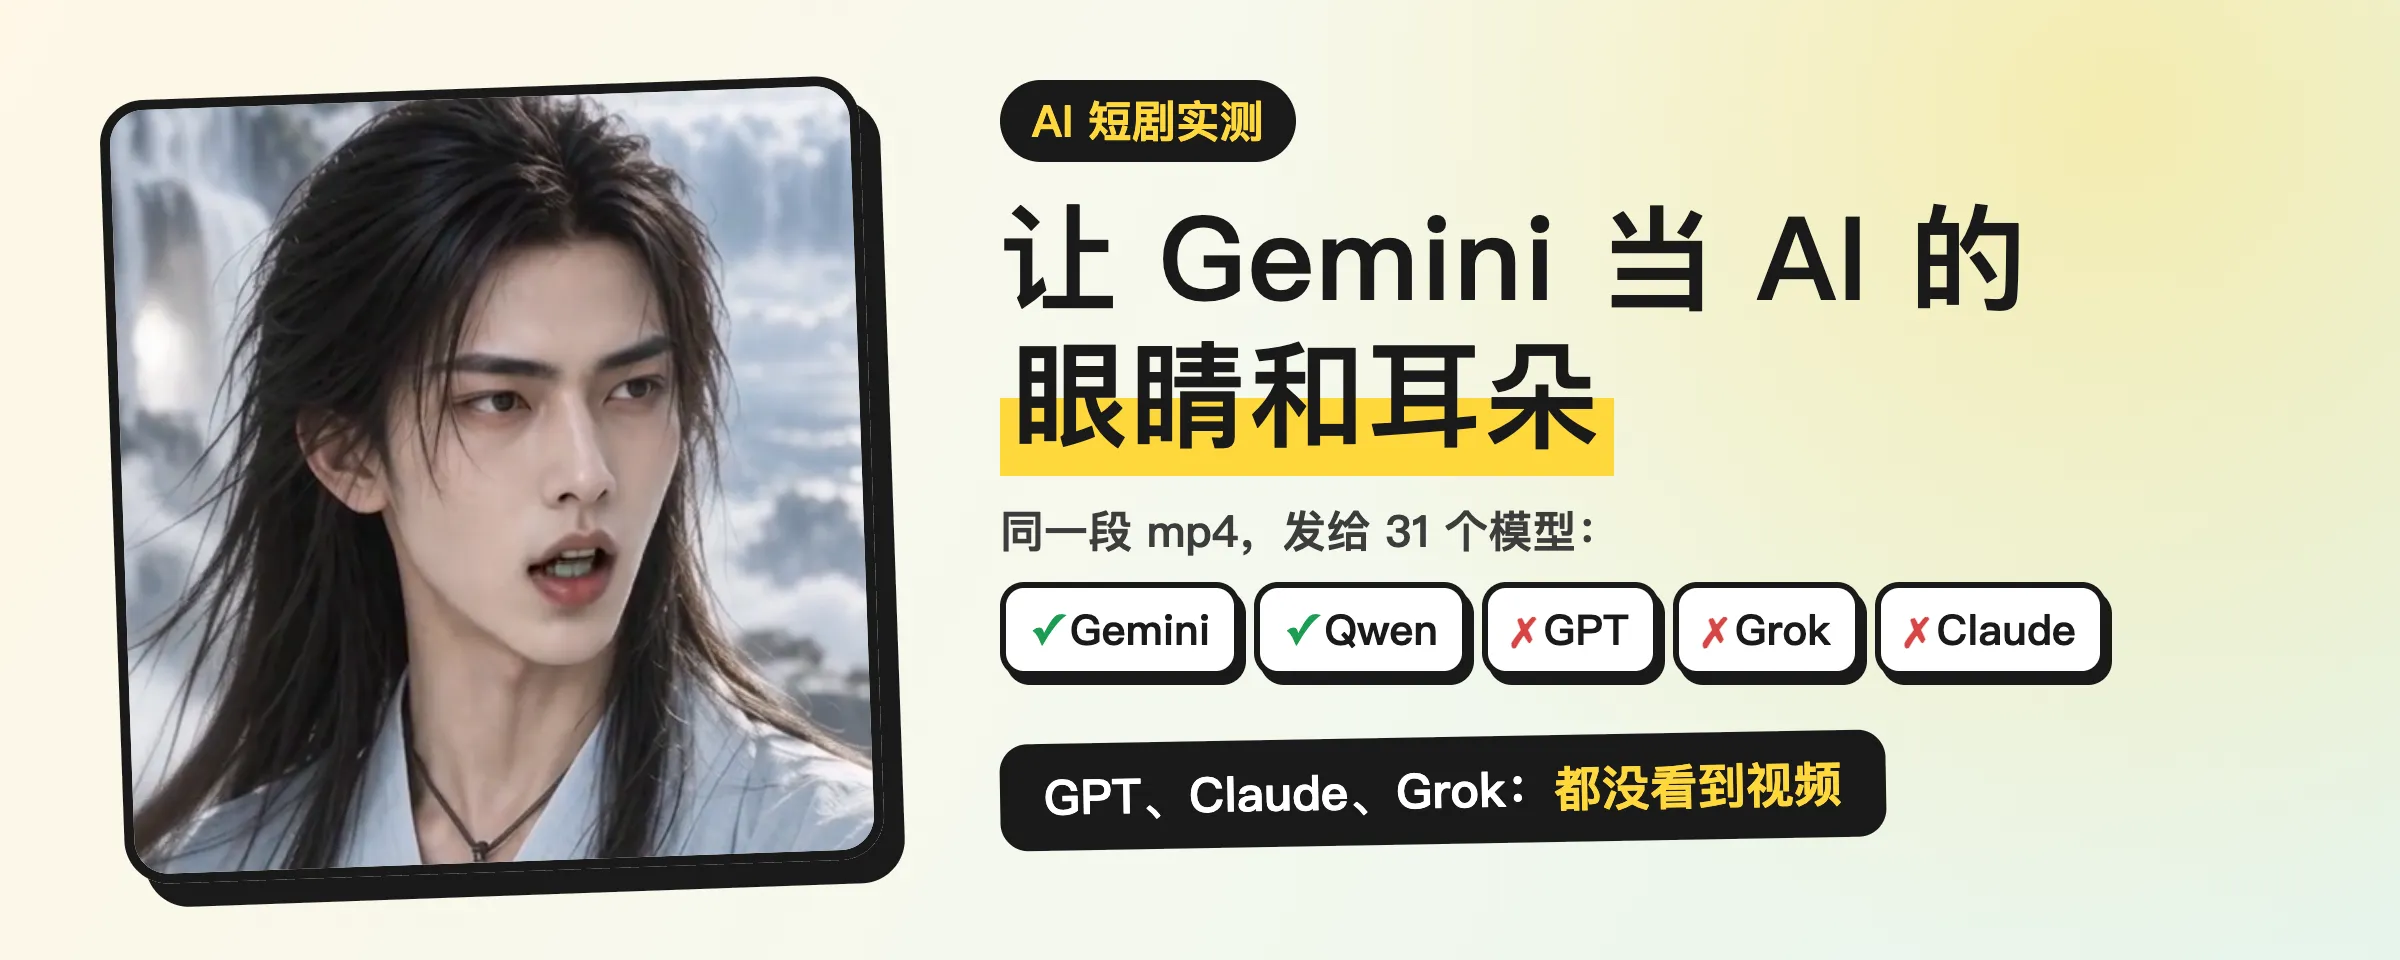
你让 Claude Code 或者 Codex 做短剧,它一口气生成几十个镜头,可它自己看不了整段视频,也听不了声音。台词念对没有、嘴对没对上、该从第几秒剪,全得你一条条点开看。我们第一集渲染了 44 条,才留下 29 条。
我们的办法是给它配一副眼睛和耳朵:把整段 mp4 丢给 Gemini,让它看完听完,回一份带秒数的报告,AI 照着报告决定重做还是剪。
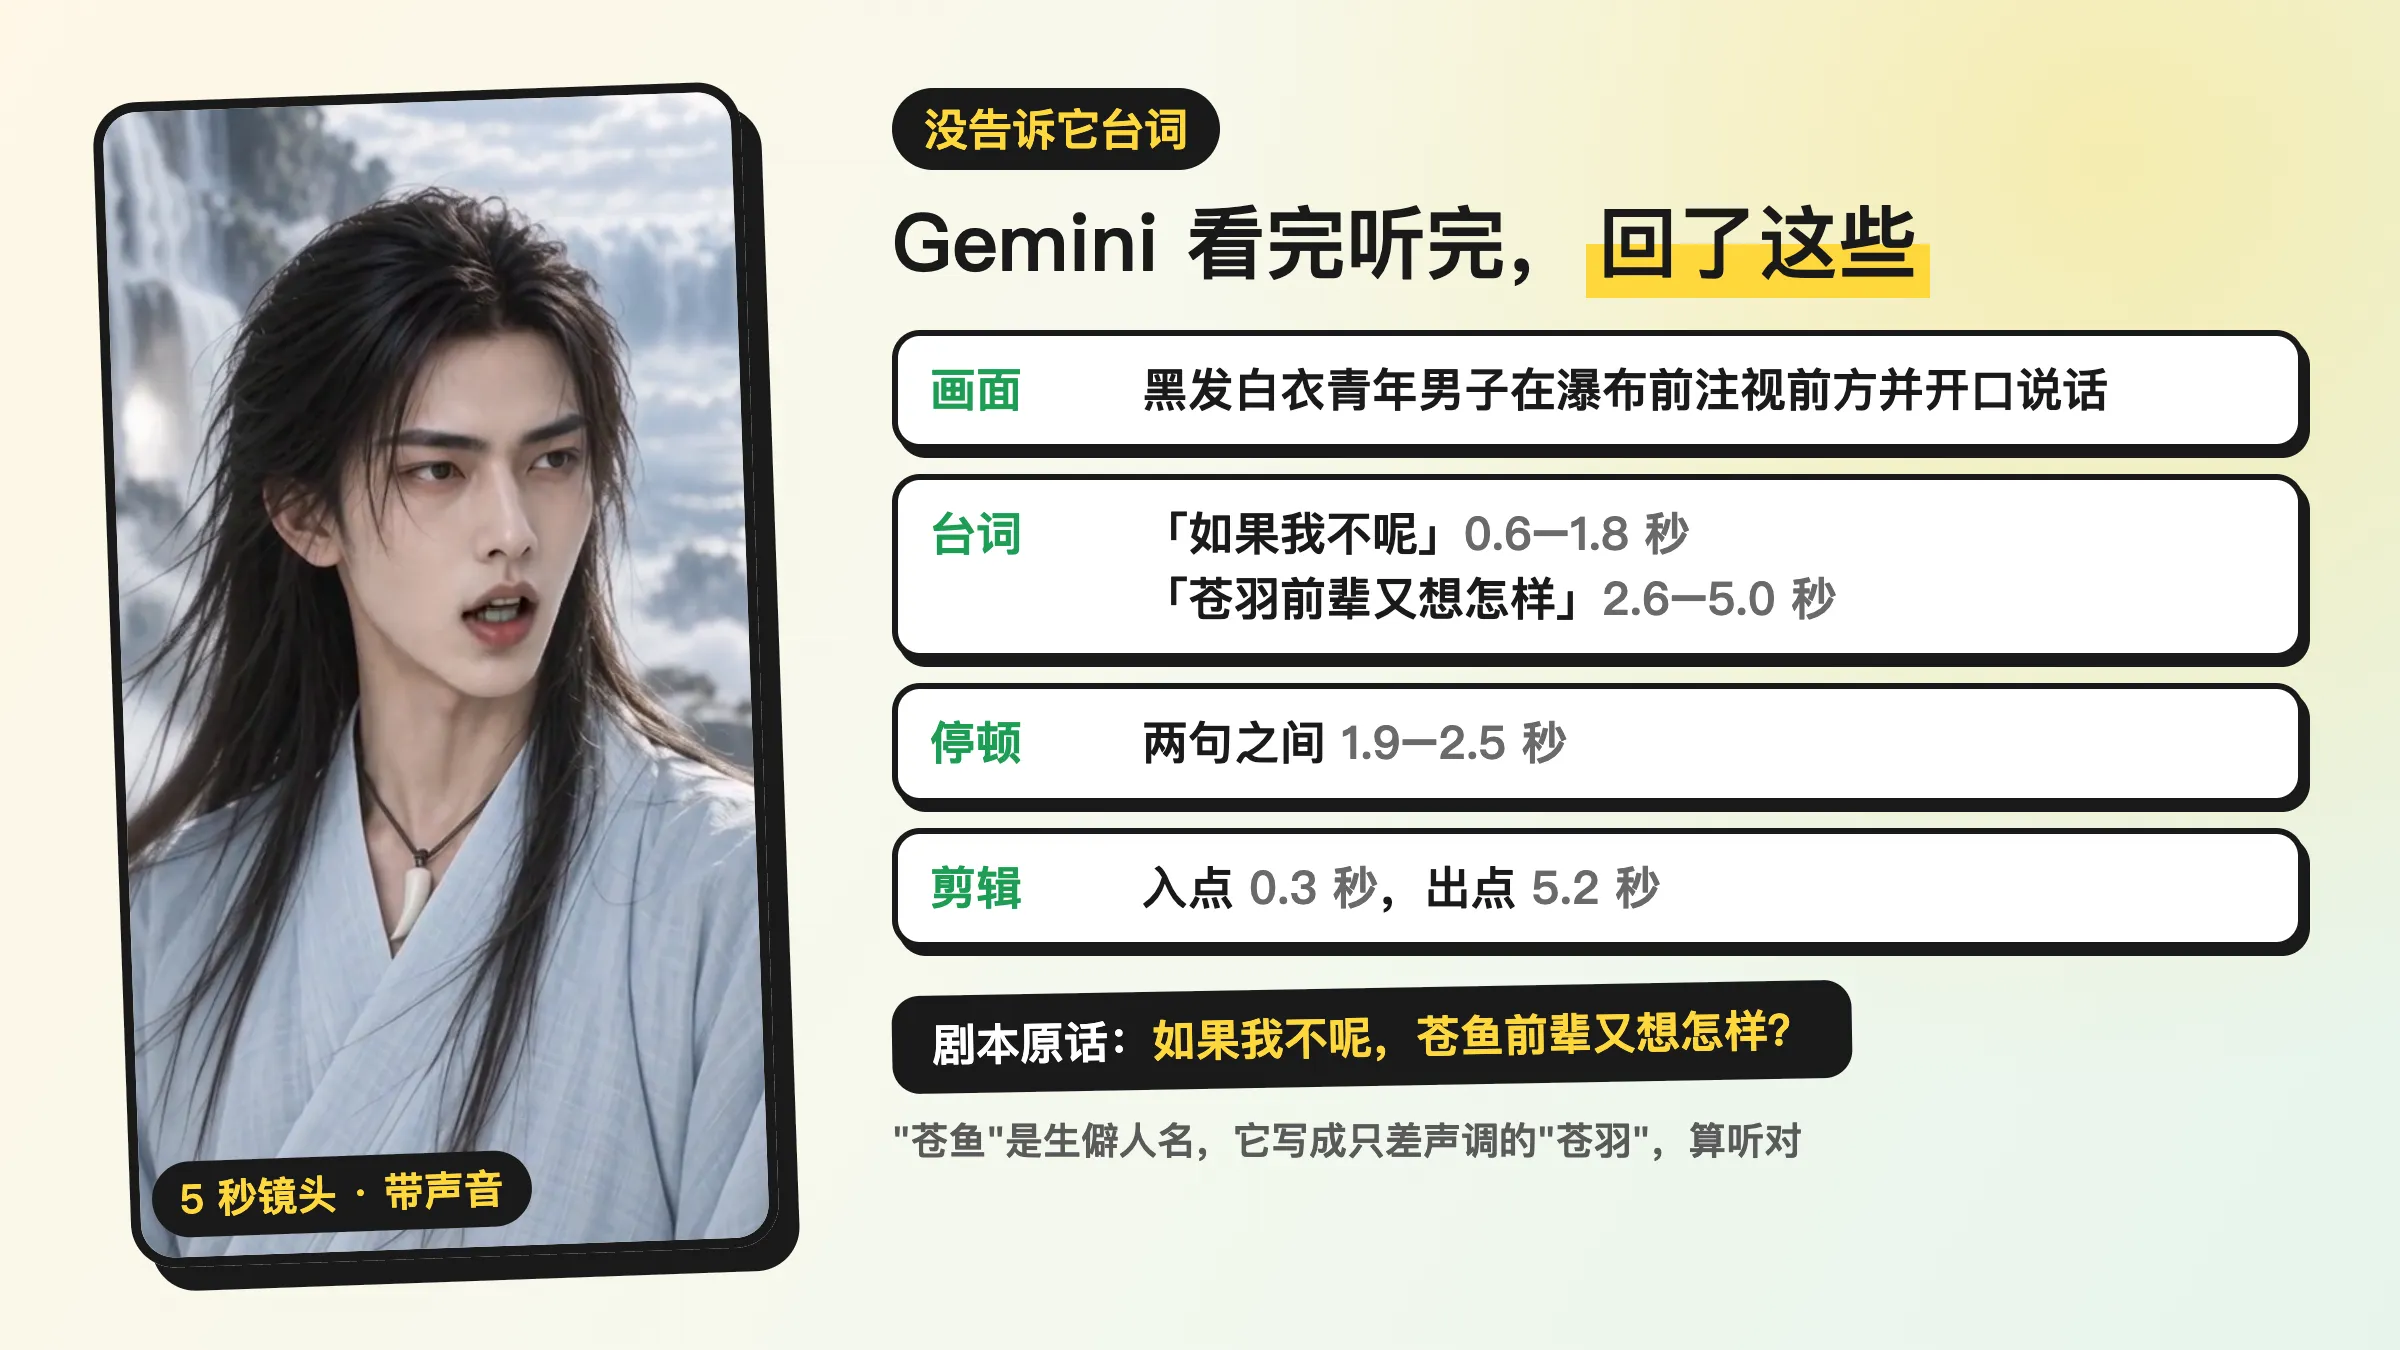
选 Gemini 是测出来的。我们把这个 5 秒镜头发给了 31 个模型,什么提示都不给,只问里面说了什么、发生了什么:
| 模型 | 结果 |
|---|---|
| 8 个 Gemini | 画面说对了,台词听出来了,其中 4 个把“不呢”听成“不能” |
| 阿里 Qwen3.8-Omni-Flash | 画面说对了,台词听出来了 |
| 8 个 GPT | “我没有收到视频” |
| 12 个 Grok | “我没有收到任何视频” |
| Claude Opus 5.5、Sonnet 5.5 | 直接报错 |
GPT 和 Grok 的接口不收视频,这段 mp4 没到它们手里。我们让它们没收到就直说,20 个都照做了。
Gemini 和 GPT、Claude、Grok 差在哪
| Gemini | GPT、Claude、Grok | |
|---|---|---|
| 画面 | 收整段视频,默认每秒看一帧 | 不收视频,只能自己抽帧发图 |
| 声音 | 和画面一起进同一个模型 | 进不去,得另接语音识别 |
| 时间 | 每一秒自带时间戳 | 自己在提示词里标 |
| token | 一秒视频约 90,画面是低分辨率 | 一帧图 450 到 570 |
Gemini 从第一代起就把视频帧和声音当成和文字一样的输入来训练,Google 还拿 YouTube 的视频训练它。GPT、Claude、Grok 的模型文档里,输入写的都是文字和图片。
所以它答得出哪句话从第几秒说到第几秒,还便宜:我们 2 分 21 秒的整集,它读一遍才 1.3 万 token。
我们让它干的四件事
| 干什么 | 它回什么 | AI 拿来做什么 |
|---|---|---|
| 核对台词 | 逐字听写,每句从第几秒到第几秒 | 和剧本不一样,这个镜头重做 |
| 找入点和出点 | 第一个动作之前、最后一句话之后的秒数 | 交给 ffmpeg 剪 |
| 挑瑕疵 | 道具变形、眼睛变色、人凭空出现,带秒数 | 决定留不留 |
| 当第一个观众 | 没读过剧本,看完整集把剧情讲一遍 | 它讲不出来的地方,就是没拍明白 |
用哪个
能看能听的 9 个里,我们挑了三个,拿同一批镜头和同一集各跑两遍:
| Gemini 3.8 Flash(思考 high) | Gemini 3.1 Pro(思考 low) | Qwen3.8-Omni-Flash | |
|---|---|---|---|
| 单镜头台词,人名除外 | 全对,但有一段素材每次都交白卷 | 全对 | 全对 |
| 开口时间 | 平均差 0.05 秒 | 平均差 0.1 秒 | 一半镜头准,一半晚 0.7 到 1.4 秒 |
| 整集 28 个切点,半秒内算中 | 24 个、11 个 | 28 个、28 个 | 22 个、21 个 |
| 一个镜头要等 | 9 秒 | 27 秒 | 42 秒 |
| 把音轨删掉 | 两遍都编出台词 | 不编台词 | 不编台词,有一遍说有水声 |
- 单个镜头用 Gemini 3.8 Flash。 最快,台词和时间都准。它交白卷的那条换另外两个,原因我们没查出来。
- 整集用 Gemini 3.1 Pro。 两遍都找全了切点和 10 句台词。
- 台词拿不准,让 Qwen 再听一遍。 换一家模型复核;字幕漏打的那句,它写的是声音。记得开思考,关掉会丢台词。
它会骗你的四个地方
- 没声音,它照样“听得到”。 我们把音轨删掉再发过去,3.8 Flash 两遍都交了台词,两遍的词还不一样,时间跟着嘴型走。发之前先用 ffprobe 确认片子真有音轨。别把剧本台词写进提示词,让它盲听,拿回来再和剧本对。
- 片子上有字幕,它就照着念。 成片烧了字幕时,三个 Gemini 把生僻人名“苍鱼”写得一字不差。去掉字幕,它们写成了“苍宇”“苍俞”“苍余”。有句台词字幕少打了两个字,三个里两个跟着少,去掉字幕全都听出来了。要查配音,给它没字幕的版本。
- 过了一分钟,3.8 Flash 的秒数会变成分秒。 141 秒的整集,它把 2 分 04.3 秒写成 204.3。两遍都这样,第二遍连切点也这么写。写错的 5 句台词里有 3 句没超过片长,光查片长查不出来。3.1 Pro 和 Qwen 两遍都没这个毛病。
- 一次问太多,瑕疵就漏。 有个镜头有三处真瑕疵:玉杖变形、眼睛中途变色、人从浪尖一下到了平海。十项一起问,4 个 Gemini 各跑两遍,24 次机会只找到 7 次。单独问瑕疵,并列出要查哪几类,找到 21 次。
抽帧发给 Claude Opus 5.5,同一个大提示词下这三处它全找到了,也有误报;只跑了一遍,token 是 Gemini 的 5 倍。只挑画面瑕疵时可以加这一道。
Gemini 默认每秒只看一帧,3.7 Flash 两次把一个快推镜头报成了硬切。要精确到帧的切点,用 ffmpeg 的镜头切换检测;同一个人、同一景别的切换它会漏,我们那集有 4 个,3.1 Pro 两遍都找到了。
配音好不好听、这个镜头留不留,还是人拍板。
贴给 AI 的话
给这个项目写一个 watch 脚本:把一段 mp4 整个发给 Gemini 3.8 Flash(思考 high),让它看完听完,只输出 JSON:
时间线、镜头运动和硬切点、台词(逐字听写、起止时间、嘴在不在动)、建议的入点和出点。
不要把剧本台词告诉它,听写回来再由脚本和剧本比对。发之前用 ffprobe 确认有音轨。
返回空就换 Gemini 3.1 Pro 重试。瑕疵单独再问一遍,列出要查的几类。
整集用 Gemini 3.1 Pro,发没烧字幕的版本;切点再用 ffmpeg 的镜头切换检测对一遍。
以后每生成一个镜头就跑一次:台词和剧本不一致就重做,一致就按建议的点剪。
怎么测的
- 素材是我们自己做的一集仙侠短剧,画面和中文配音都是 AI 生成的:3 个单镜头、1 条三镜头拼接、1 条 2 分 21 秒的整集。
- 台词以剧本为准,用 Whisper 核对过;人名“苍鱼”只差声调也算对。切点以剪辑表为准。
- 每项跑两遍。烧字幕的整集和 Claude 抽帧只跑了一遍。
- 温度设为 0。Google 建议 Gemini 3 用默认的 1.0,所以交白卷的那条我们换成默认温度和 1.0 又各试了两遍,还是空。
- GPT、Grok、Claude、Gemini 走我们自己的模型网关,Qwen 走阿里百炼。Qwen 用 base64 直传限 10 MB,它拿到的整集压得更小。
- 没看到视频的 22 个模型,两遍都没看到。换一种发法,把 mp4 当文件附件传,GPT 的接口直接回了
unsupported MIME type 'video/mp4'。
来源:Gemini 视频理解文档、Gemini 1.0 技术报告、CNBC 关于 YouTube 训练数据的报道、OpenAI、Claude 和 Grok 的模型文档。
AI 怎么把片子做出来,在上一篇《一句话让 Opus 5.5 做出视频》里。
你有办法让 GPT、Grok、Claude 直接看 mp4,或者发现哪里测得不对,欢迎来讨论,我们重测。
你的 AI 现在怎么检查它自己做的视频?